体育游戏app平台这对应"裁判创新轮回"-开云(中国)kaiyun体育网址入口-在线登录
 体育游戏app平台
2026岁首,NVIDIA的一群估量者碰到了一个挺无言的问题。
他们老师了一个自动驾驶推理模子,让它一边开车一边解释"为什么我要这样作念"。比如看到前车短暂降速,它会说"因为检测到右前哨有行东说念主行将穿行"。这套系统跑了几轮强化学习后,进展照实在涨。但涨着涨着,团队发现不合劲了:模子的分数一直在往上走,可东说念主类行家去看它的实践推理内容,却以为越来越离谱。
这不是模子变笨了,正巧相背,是裁判变笨了。
**用来打分的阿谁AI评判模子,还是跟不上被评判的AI的进化速率了。**
这个表象在强化学习圈子里有个说法,叫"奖励黑客",指的是模子学会了若何骗过打分系统,而不是的确把事情作念好。但VeriFine这篇论文想问的问题更深一层:要是裁判自身的才能是固定的,那这场游戏早晚要崩。的确的解法不是修补裁判的某个随意,而是让裁判也随着学生通盘越过。
这篇论文便是在讲,他们是若何让"学生"和"裁判"通盘升级的。
一个会话语的AI司机,到底难在哪
先说表现这篇论文估量的场景有多突出。
市面上大多半作念AI自我擢升的估量,针对的是数学题、代码题这种**有圭臬谜底**的任务。模子作念对了便是作念对了,裁判只需要查对谜底,不需要连结"为什么"。但自动驾驶和机器东说念主导航完全不是这样回事。
一辆车濒临归拢个路况,可能有好几种合理的应酬样式:不错变说念超车,也不错降速跟车,只消安全、合乎逻辑,都算对。这便是论文里提到的
**具身推理**:指AI在真什物理天下中作念决策时需要用到的才能,包括看懂空间位置关系、连结时分先后门径、推断因果关系、以及在保证安全的前提下作念弃取。
莫得惟一正确谜底,这事就忙绿了。你没法浮浅地拿一个圭臬谜底去比对,只可靠"懂行的东说念主"来判断这个推理是不是站得住脚。
在这篇论文之前,业内常见的作念法是什么样的?估量者提到一个叫LingoJudge的评判系统,它的职责样式是把AI生成的推理笔墨和东说念主类行家写的参考谜底作念笔墨层面的比对,看相似度打分。问题是,这玩意儿根底不看视频画面,贞洁比笔墨。
这就好比考官点窜一篇对于"描写目前这幅画"的作文,考官我方却闭着眼睛,只靠对照别东说念主预先写好的范文来打分。要是学生写了一个范文里没提到但相似正确的细节,考官根本无从判断,只可按"没对上"处理。
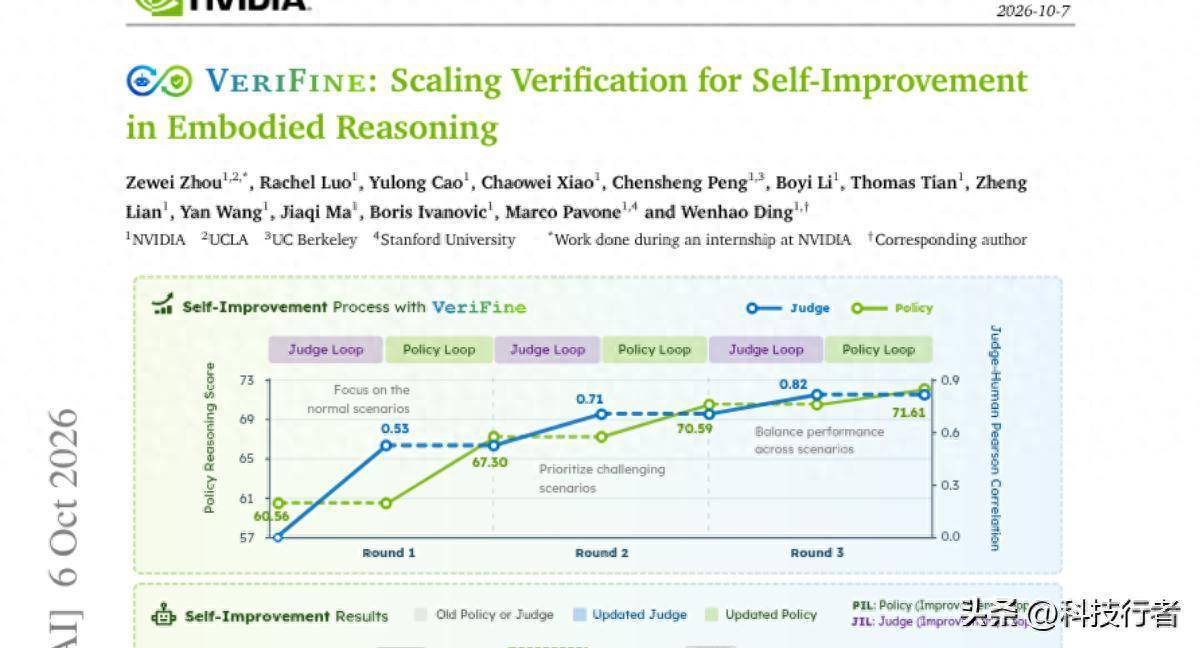
论文测了一下,LingoJudge和东说念主类行家打分的相相关数只好0.65(这个悉数最高是1,代表完全一致)。而VeriFine我方老师出来的裁判模子,相相关数达到了0.82。差距不算小。
这背后其实是一个更根本的遐想秉承:要不要依赖东说念主工写的参考谜底。
依赖参考谜底的裁判,叫
**参考式评判**:评判时需要对照东说念主类预先写好的圭臬谜底或参考推理来打分。
不依赖参考谜底、径直看着原始场景(画面、车辆情状、任务指示)我方判断的裁判,叫
**无参照式评判**:不需要任何东说念主类预先准备的参考谜底,径直根据不雅察到的物理场景自身来评估AI的推理是否合理。
为什么无参照式更难作念,但VeriFine偏专爱选这条路?因为参考谜底这东西自身便是个瓶颈。每一条参考推理都要东说念主工写、东说念主工查对,本钱极高,何况参考谜底只可代表"一种"正确解法,会把其他相似合理但表述不同的谜底误判为极度。更要命的是,当policy(也便是被老师的阿谁AI)水平越来越高,它给出的创造性谜底会越来越多,固定的参考谜底库根本追不上。
是以VeriFine干脆让裁判径直看懂物理天下自身,不依赖任何东说念主写好的圭臬谜底。这个秉承的代价是裁判要作念的事变难了好多,但公正是它能随着被评判对象通盘成长,而不是被钉死在某一版参考谜底上。
两个齿轮,咬合着通盘转
VeriFine这套系统的中枢遐想,是两个相互咬合的轮回,论文里称为
**计谋创新轮回**:以裁判模子的评判截止为依据,发现AI计谋的反复出现的失败模式,据此挑选老师数据、优化AI模子自身的过程。
**裁判创新轮回**:当计谋创新碰到瓶颈时初始,有秉承性地请东说念主类行家审核一些信息量大的失败案例,并据此修正裁判模子打分圭臬的过程。
这两个轮回为什么要分开遐想,而不是混在通盘一次性惩处?
瞎想一下你在健身房请了一个私教。前几周,私教根据你现在的水祥瑞排老师有操办,那处弱练那处,这个阶段私教不需要无为调换我方的判断圭臬,只消践诺就行,这对应着"计谋创新轮回"。
但练了几个月后,你的体能基础发生了质的变化,私教原来那套"入门者圭臬"还是不适用了,继续用老目光看你的老师效果,可能会以为"越过不显豁",其实是私教的评判尺子该换了。这手艺就需要私教停驻来,从头校准我方对"什么算好"的判断,这对应"裁判创新轮回"。
要是莫得这个停驻来从头校准的智商会如何?私教学一直用落伍的圭臬条目你,你要么以为弥远够不上预期而废弃,要么便是真的卡在瓶颈上不去,而私教还蒙在饱读里以为有操办没问题。
论文里挑升遐想了一套机制来判断"什么手艺该停驻来校准裁判",这个机制叫
**范围检测**:通过持续监测计谋模子在固定测试集上的进展变化,以及裁判给出的奖励分数变化是否同步,来判断现时裁判的评判才能是否还是跟不上计谋的越过、需要东说念主工介入校准了。
具体若何判断呢?论文设了两个信号。一个是看计谋在最近几轮老师里越过有多大,要是越过幅度很小,说明可能碰到了瓶颈。另一个是看裁判打的分数变化趋势,和计谋真实进展的变化趋势是不是对得上。要是裁判一直在说"你越过了",但真实测试进展其实没若何涨,这便是个危境信号,说明裁判可能在被"刷分"而不自知。
这个双重判断挺机灵的,单看越过幅度可能会误判(万一仅仅这个阶段任务自身就相比难呢),但越过幅度小+裁判奖励和真实进展脱节同期出现,基本就能阐明问题出在裁判身上了。
当东说念主类行家被请出来,他们到底在作念什么
裁判创新轮回初始后,接下来要作念的事情论文里起了个挺有酷爱的名字,叫
**协同校准**:东说念主类行家和AI系统反复沟通、相互指出分歧、迟缓结伙判断圭臬的过程,而不是东说念主类片面给AI一个"圭臬谜底"让它死记硬背。
这个遐想秉承值得多说几句,因为它颠覆了一个常见的直观。
无为咱们会以为,既然要用东说念主类行家来校正AI,那进程应该是:东说念主类看一遍案例,打一个分,AI把这个分数当真义学进去就罢了。论文里明确反对这种作念法,原文说得很径直:**东说念主类的判断不会被当成十足正确的真义**。
为什么不把东说念主类当成十足泰斗?因为具身推理这件事自身就充满了暧昧地带,东说念主类行家我方注目案例的手艺,濒临复杂路况,也可能第一眼判断有偏差,或者评判圭臬之间相互打架。要是把东说念主类第一反映当成铁律灌给AI,AI学到的可能是一个有短处的圭臬,何况这个瑕疹以后很难被发现和修正。
论文描写的实践进程是这样的:东说念主类行家先对一批案例作念个简单打分。然后AI系统(由Claude Opus 5驱动的裁判模子)会自主地反复提议轨则矫正决议,去匹配东说念主类的校准截止,这个过程不需要东说念主盯着。等AI我方摸索到一个瓶颈,和东说念主类校准截止对不上又擢升不了的手艺,AI会把有争议的案例连同我方的会诊分数、评判原理通盘呈现给东说念主类行家。
这手艺东说念主类行家不错作念四件事:阐明AI的判断是对的、纠正某个具体的评判维度、知晓一个正本界说暧昧的圭臬、甚而修改我方之前给的分数。
这其实是一个双向纠错的过程,不是东说念主片面教AI,也不是AI片面劝服东说念主,而是双方反复碰撞,直到谁也说不出更好的原理为止,论文管这个敛迹至极叫"物理推理的客不雅评判圭臬"。
这就好比两个法官通盘审一个案子,初审观念不结伙的手艺,不是经验老的阿谁说了算,而是两东说念主把各自的依据摆出来反复申辩,直到完好意思一个双方都认同、逻辑能自洽的论断。要是是经验老的径直拍板,名义上省事,但万一这个老法官本日情状不好、看漏了关节根据,这个极度判断就会变成"圭臬谜底"一直沿用下去,何况因为莫得申辩过程,这个极度根本没契机被发现。
校准完成后,被反复打磨过的评判圭臬,论文称之为
**轨则表**:把具身推理拆解成多少个不错打分的细分维度,比如"视觉依据是否准确"、"是否考虑了通盘相关的场景成分"等,用结构化的样式而不是单一隐隐的分数来评判AI推理质料的评分圭臬。
有了细分维度之后,裁判就不仅仅给一个暧昧的"这个推理70分",而是能告诉你"你的安全性判断是对的,但视觉依据只诡秘了场景里的一半关节信息",这种细粒度反馈对老师来说价值大得多。
师生架构:为什么不可一直用最强的AI当裁判
这里有个很现实的工程问题:Claude Opus 5这种顶级大模子当裁判,判断力照实强,但它贵,何况慢。
论文测了一下,用Opus 5评判一个样本要花20.92秒。而自动驾驶的强化学习老师,一轮更新就要跑512次模拟(32个场景乘以16次采样),要是每次都要等Opus 5判上20秒,这老师速率会慢到没法用。
于是VeriFine选定了
**师生蒸馏架构**:让一个雄壮但速率慢、本钱高的大模子(教师)先把评判教养学到位,再把这套评判才能"教"给一个体积小、速率快的模子(学生),学生模子学会之后就能在大鸿沟老师中快速打分,不必每次都请问师模子亲身出马。
这个念念路其实挺朴素的,就像一个病院里,行家门诊号难挂、用度高,但行家不错培训一批下层大夫,让他们掌执会诊圭臬后去应酬大部分通俗病例,的确疑难的病例才转诊给行家。论文里,学生模子是基于Qwen3-VL 2B这个较小的视觉语言模子老师出来的。
效果如何?学生模子处理一个样本只消0.07秒,比教师模子快了约莫300倍,同期在东说念主类对皆度上达到0.82的相相关数,还是贴近教师模子的0.85,远超LingoJudge的0.65。
这里有个细节值得缜密。论文作念了个对比实验,要是不给学生模子作念"PAI-AV预老师"(也便是先在里面驾驶数据集上作念过挑升的视觉编码预老师),学生模子的进展会显豁差一截,相相关数从0.82掉到0.76,谬误也会从0.17涨到0.19。这说明光靠蒸馏教师的判断逻辑还不够,学生我方也得先对物理天下有基本的感知才能打底,才能的确学懂教师在说什么。
另外论文还相比了不同的输出样式。让模子像写稿文一样生成齐备的推理笔墨再给分,和径直用分类器头输出结构化分数,两种样式的判断准确率差未几,但前者的推理耗时是后者的30多倍。这个权衡很现实,在不亏本太多准确性的前提下,把评判速率擢升30倍,对于需要海量调用裁判的强化学习老师来说,这简直是决定面貌能不可跑起来的关节。
数据话语:三轮迭代到底带来了什么
说了这样多遐想念念路,实践效果若何样?
论文在自动驾驶推理任务上跑了三轮齐备的"计谋创新轮回加裁判创新轮回"。用固定的参考式评判圭臬(VeriFine-Judge-RB)来权衡,计谋的推理得分从60.56一齐涨到71.61,相对擢升18.2%。要是用进化后的无参照裁判来权衡,擢升幅度更大,达到22.2%。
论文还作念了个很关节的对照实验,用来证明"课程数据挑选得好"这件事自身有莫得用,而不仅仅裁判打分准不准的问题。他们保持每一轮的奖励裁判不变,只对比"赶紧挑老师数据"和"用裁判智能挑老师数据"这两种作念法。截止泄露,三轮里裁判提醒的数据挑选分袂比赶紧挑选高出14.6%、8.1%、4.5%。
这说明一件事:**光有一个更准的裁判还不够,若何用这个裁判去挑该学什么相似清贫。**
这背后的酷爱也不难连结。假定班里学生还是把浮浅题都作念对了,本分继续让他刷浮浅题,分数不会再涨,因为莫得新的学习信号。的确灵验的作念法是找出学生还不会的那部分,针对性地加练。VeriFine的课程构建逻辑恰是这样,裁判发现计谋在哪类场景上反复出错,就优先把这类场景的数据挑出来用于老师,同期过滤掉那些AI我方答错了、不妥贴动作学习范本的样本。
裁判这一边的越过相似显贵。教师模子(Opus 5)在校准前后的对比很能说明问题:校准前和东说念主类的相相关数是0.67,校准后擢升到0.85。这证明越过不是单纯靠换了个更强的底层大模子带来的,协同校准这个过程自身照实在起作用。
论文还作念了个很有酷爱的测试,叫测试时膨大,浮浅说便是让一个计谋模子针对归拢个场景生成6个不同的候选谜底,然后看不同裁判能不可从里面挑出东说念主类认为最佳的阿谁。截止泄露,进化到第三轮的裁判,挑出来的谜底东说念主类评分达到78.6分,显豁越过赶紧挑选和LingoJudge,和参考式裁判打了个平手。这意味着裁判的进化后果不单局限在老师阿谁闭环里,它学到的判断力能的确泛化到老师以外的新场景中去用。
换个任务试试:机器东说念主也能这样练
一个框架要是只可用在一个任务上,劝服力总归差点酷爱。论文又把VeriFine搬到了机器东说念主室内导航任务上,用的是VLNVerse这个基准环境。
此次情况不太一样,驾驶任务用的是强化学习(GRPO),裁判分数径直作为奖励信号参与优化。而导航任务用的是
**监督微调**:径直用挑选出来的高质料示范数据去让模子效法学习,裁判在这里不参与缠绵亏本函数,只精致从候选数据里筛出哪些值得拿来当课本。
换句话说,裁判的变装从"打分发奖金"变成了"选课本",这是两种完全不同的参与老师的样式。论文想考证的是,VeriFine这套co-evolution的逻辑,是不是只在强化学习这种特定优化样式下才管用,如故说它是一个更通用的念念路。
截止泄露,导航任务上的计谋推理得分从68.09擢升到77.59,涨幅14%,裁判和东说念主类的相相关数也达到了0.85。论文给了个具体例子挺天真的:一个旧计谋正本会在白色柜子附近"右转经过",更新后的计谋学会了正确判断"应该停在陶瓷盆栽前边",纠正了一个正本会走错方针的伪善。
这个跨任务的考证,某种进程上陈述了一个更根本的问题:自我擢升和裁判共同进化这套机制,到底是驾驶场景的特例,如故具身智能的通用礼貌?从现在的截止看,至少在驾驶和导航这两个相反不小的任务上,这套逻辑都走得通。
写在后头
读完这篇论文,我一直在琢磨一件事:为什么"裁判要随着学生通盘进化"这个想法,听起来这样直观,但在实践系统里却很少有东说念主的确把它作念塌实?
我猜原因是,让裁判进化这件事,自然需要承认一个活气意的真相:你今天老师出来的评判圭臬,来日冒失率是不够用的。这意味着你没法把裁判当成一个一劳永逄的基础设施去搭建,它得被当成一个和计谋模子地位同等、需要持续进入资源诊疗的东西。好多团队在作念强化学习系统的手艺,默许把reward model当成固定不变的"裁判配景板",这篇论文等于是在说,你这个配景板总有一天会穿帮,不如提前遐想好什么手艺该换。
另一个让我印象相比深的细节,是论文反复强调"东说念主类不是十足真义"。这跟好多东说念主对RLHF(东说念主类反馈强化学习)的直观连结是有相差的,好多东说念主默许东说念主类标注便是ground truth。但协同校准这个遐想说的是,东说念主类行家我方的判断也会出现矛盾和盲区,的确可靠的不是某一次东说念主类打分,而是东说念主类和AI反复碰撞、相互纠错之后敛迹出的阿谁截止。这其实有点像科学共同体变成共鸣的过程,不是靠一个泰斗施命发号,而是靠持续的、带着怀疑精神的相互老师。
论文我方也坦承了一些没解决的问题。比如固定的policy测试集固然提供了融会的对比基准,但内容上亦然静止的,莫得随着计谋和裁判通盘进化,改日要是测试集自身也能动态妥贴新出现的失败模式,可能会提供更有信息量的信号。另外整套系统现在还离不开东说念主工撰写、核验的参考推理数据,想要透彻解脱对东说念主工标注的依赖,只怕还需要让"写参考谜底"这件事自身也变成不错自我进化的一环。
一个AI系统最终能走多远,可能不取决于它学得有多快,而取决于阿谁给它打分的裁判,愿不肯意,以及能不可,陪着它通盘变得更机灵。
Q&A
Q1:VeriFine是什么?
A:VeriFine是NVIDIA团队提议的一套智能体框架,中枢念念路是让AI计谋模子、老师课程和评判裁判三者协同进化,解决自动驾驶和机器东说念主导航等具身推理任务中固定裁判跟不上计谋越过的问题。
Q2:VeriFine和传统的参考式评判方法有什么区别?
A:传统方法如LingoJudge依赖东说念主工撰写的参考谜底作念笔墨比对,不看实践场景画面。VeriFine选定无参照式评判,裁判径直根据视频画面、车辆情状等物理场景自身打分,相相关数从0.65擢升到0.82,更贴近东说念主类判断。
Q3:VeriFine只可用在自动驾驶上吗?
A:不是。论文同期在自动驾驶(强化学习)和机器东说念主室内导航(监督微调)两个任务上考证了框架的灵验性,导航任务的计谋推理得分擢升了14%体育游戏app平台,证明这套协同进化念念路具有跨任务的通用性。